肉眼看不出的幻觉?清华提出视觉源幻觉,仅用0.9%数据实现SOTA
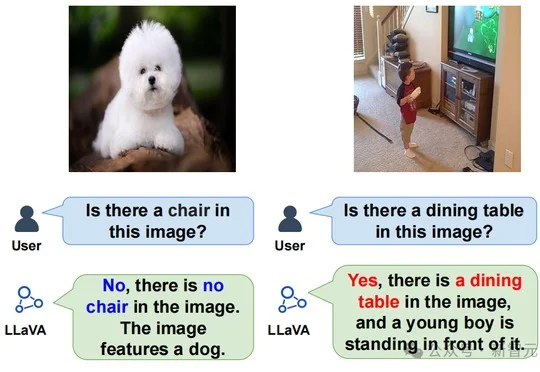
肉眼看不出的幻觉?清华提出视觉源幻觉,仅用0.9%数据实现SOTA新智元报道 多模态大模型的物体幻觉,长期被归因于语言先验。 先看下面两组对话。 第一组,一张只有小狗的照片,问模型「图中有椅子吗」,它答「没有,图中是一只狗」,完全正确; 第二组,另一张照片,问「图中
来自主题: AI技术研报
8722 点击 2026-09-20 15:07

 搜索
新智元报道 多模态大模型的物体幻觉,长期被归因于语言先验。 先看下面两组对话。 第一组,一张只有小狗的照片,问模型「图中有椅子吗」,它答「没有,图中是一只狗」,完全正确; 第二组,另一张照片,问「图中